港大評測36款大語言模型 中文語境下推理能力
更新時間:12:13 2025-08-26 HKT
發佈時間:12:13 2025-08-26 HKT
發佈時間:12:13 2025-08-26 HKT


字體大小
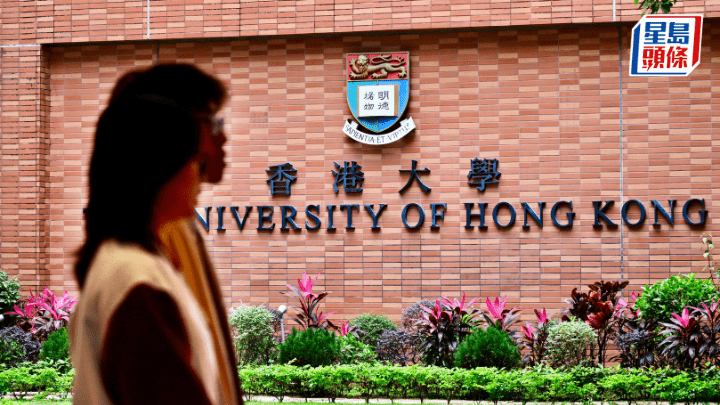
香港大學經管學院昨日發表《大語言模型推理能力測評報告》,針對36款主流大語言模型(LLM)進行中文語境下推理能力的基準測試,為AI「最強大腦」作評測。報告顯示,GPT-o3在基礎邏輯能力評測上取得領先,Gemini 2.5 Flash在情境推理能力評測中位列榜首。
港大表示,在綜合能力排名上,豆包1.5 Pro(思考模式)排名首位,Open AI近日推出的GPT-5緊隨其後,豆包1.5 Pro、通義千問3(思考模式),以及DeepSeek-R1在內的多款來自中國的LLM也均排入前列,展現了中國LLM在中文語境中優越的推理能力。

最Hit

港人創業賣麵包5個月慘蝕80萬結業?出po呻3大原因難再撐︰最恐怖唔係冇生意 網民︰相信你學到嘢
2026-10-30 08:45 HKT
內地男銀行存¥2千5變¥2萬5拒退還遭告 法院裁「離櫃免責」無效
2026-10-30 10:40 HKT
旺角截車過海接連被拒 第三架的士竟然爽快叫上車 夜歸人分享無言奇遇 落車前的哥突爆接客真相|Juicy叮
2026-10-30 13:00 HKT